Choice
「この中のどれ?」
順序のない選択肢から1つを選ぶ。チケットの振り分け、文書種別の分類、意図の判定など。1問あたり最大255択。
→ choice, probabilities, confidence
コードでは: 選択肢ごとの分岐(match / if-elif)
Choice を深掘りする →
TypeSafe / System One model
Jev(ジェヴ)は、自然言語を理解したうえで「どれか」「どの程度か」「Yes か No か」を型のある値と確率で返すモデルです。テキストを生成しないので、パースもリトライも不要。返ってきた値は、そのまま if 文・並べ替え・しきい値判定に使えます。
“Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.”(Stripe 連携が3日間失敗し続けていて売上を失っている、至急助けてほしい、という問い合わせ)
Why
LLM は人が読む文章を作るためのモデルです。コードが使う判断をさせようとすると、「文章生成システムに構造化データを吐かせて、それをまたパースする」というねじれが生まれます。Jev はこのねじれを、出力の契約そのものを変えることで解消します。
answer.choice / .score / .noul と .confidence で分岐What you can do
TypeSafe はこれを AI プリミティブと呼びます。プログラミング言語のプリミティブと同じく、小さく、組み合わせ可能で、構造化されていて、速い。欲しい答えの「形」で選びます。
「この中のどれ?」
順序のない選択肢から1つを選ぶ。チケットの振り分け、文書種別の分類、意図の判定など。1問あたり最大255択。
「どの程度?」
言葉で定義した順序付きレベル(2〜10段階)の上の位置を返す。重大度、いら立ち、関連度、経験の深さなど。
「これは真か?」
Yes/No の問いに対して「Yes である確率」を 0〜1 で返す。返金要求か、個人情報を含むか、脱獄プロンプトか、など。
if answer.noul > 0.7:| 判断の形 | こんなときに | 例 |
|---|---|---|
| 分類 | 既知のカテゴリから1つが勝つべき | 意図、トピック、担当部署、リスク種別 |
| 検知 | ある性質が存在する確率がほしい | スパム、不正、緊急性、脱獄、機微情報 |
| 採点 | 答えが順序付きルーブリック上にある | 重大度、関連度、品質、いら立ち |
| ルーティング | カテゴリが次のコードパスを決める | ツール選択、エスカレーション、モデルルーティング |
| 検索・取得 | 自然言語の問いに合う項目・文脈を探す | セマンティック検索、RAG の文脈選択 |
| ランキング | 意味的な関連度や品質で並べたい | 検索結果、推薦、候補者の優先順位 |
| 検証 | 成果物を特定の失敗モードで点検したい | 引用の裏付け、ポリシー違反、ツール呼び出しの誤り |
| 特徴量抽出 | 下流の古典的 ML に意味的シグナルを渡したい | 購買意欲、解約の兆候、競合圧力 |
| 構造化データ抽出 | 非構造データから既知のフィールドを復元したい | 候補者属性、注文項目、文書ラベル |
How it works
1回のリクエストは「1つの state」と「1つ以上の質問」でできています。質問はすべて同じ state を見て、互いに独立に、並列で評価されます。ワークフローの主導権は常にコード側にあります。
判断と確率は、コードが期待する型と JSON スキーマに必ず従う。生成された文章から値を復元する必要がない。
質問は互いに影響しない。質問を足したり引いたりしても、他の質問の結果は変わらない。
出力は数値と確率。並べ替え、しきい値、賢い if 文をそのまま書ける。
多くのクエリが約100msで完了。リアルタイムのリクエスト経路や UI に組み込める速さ。
RLCD という学習法により、過信に寄らず、不確かさを確率として正直に伝える。
同じ入力を繰り返し評価しても安定した答えを返すよう設計されている。
Patterns
プリミティブ単体よりも、「コードとどう組み合わせるか」で価値が決まります。公式ドキュメントが挙げる4つの設計パターンです。
必要になるかもしれない質問も含めて1回で全部聞き、どの答えを使うかはコードが後で決める。13問をまとめると、個別に13回呼ぶよりコストも速度も10倍前後改善する(公式クックブックの計測例。コスト 11.5〜12.2倍、速度 9.6〜10.0倍)。
RELIABILITY · SAFETY答え(何を)と confidence(実行してよいか)を2軸で使う。残高照会は 0.6 で通し、送金承認は 0.85 を超えなければ確認を挟む、というようにリスクに応じて閾値を変える。
COST · RELIABILITY · SPEED複雑な評価を独立した次元に分解して別々に採点し、重みはコードで持つ。優先順位が変わったら、プロンプトではなく係数を書き換える。
COST · SPEED高価な LLM の手前に置く高速な分類器として使う。DB 参照で済むものはコードへ、専門知識が要るものは専用 LLM へ、難しいものは人へ。
Use cases
「速い・安い・型がある」という性質が効く領域は、大きく5つに分けられます。
人の監視なしでバックグラウンドで100万回回せる形で、AI と信頼できるコードを織り交ぜる。制御フローはコードが持ち、意味の判断だけを Jev が担う。
人の知覚より速い判断(公式は150msと表現)。ゲームの挙動や UI の中に埋め込める。
桁違いに安いので巨大データを総なめできる。巨大コーパスの検索、エージェントのトレース分類、予測用の特徴量抽出。
他の AI の入力・抽出結果・推論トレース・ツール呼び出しを検証。脱獄、引用ミス、ハルシネーションを、LLM 呼び出し本体よりずっと安く検知。
エージェント基盤そのものを賢くする。モデルルーティング、意味的な文脈検索、ガードレール、推論トレースの分類。
法律文書検索(CLERC、40クエリ)。BM25 の上位30件を Jev で再ランクし、top-1 正解率が向上。top-10 は 38% → 62%。
GitHub 利用規約の全218行を、1回のリクエストで平易な質問に対してスコアリング。文書に答えがあるかも Noul で同時に確認。
エージェントの1ターンに対し、182個のスキルカタログから最大1つを選ぶ。1回目で全件をランク、2回目で上位3件を精読して棄却も可能。
2つのビールカタログの候補ペアが同一商品かを判定。Score の3レベルをそのまま「統合/リンクしない/人に回す」に対応させる。
SEC 年次報告書を75業種に分類。confidence が低ければ、細かい業種ではなく一段上の区分で報告する。
LLM への入出力を1リクエストで検査。脱獄の試みか、従った場合の害はどの程度か。RAG では矛盾する文や隠れた指示を含む文をコードで除外。
In practice · run 20260917T052508Z
説明だけでは実感が湧かないので、このサイトの全9ページを実際に jev-1.13.0 に読ませました。以下は実際に API を呼んだ結果です。どの型で、どんなプロンプトを送ったかもそのまま載せています。判定対象は、このセクションを追加する前の版です。
ページ監査 9回(1ページ=1リクエスト)+ 主張の検証 1回。
1リクエストに 12〜13 問をまとめて投げるファンアウト。
input の合計。output は 3,095 トークン。
中央値(最小 447 / 最大 715)。日本からの往復時間を含む実測値。
{ page: { path, title, text }, site_footer }。HTML から本文を抽出。日本語のまま| 型 / 質問 ID | instructions(送ったプロンプト) | criteria |
|---|---|---|
CHOICEpage_role | What role does this page play within a documentation site? {"inspect": ["`page.title`", "`page.text`"], "focus": "Classify the page's primary job, not every topic it mentions."} |
|
SCOREassumed_knowledge | How much prior knowledge does `page.text` assume of its reader? |
|
SCOREconcreteness | How concretely does `page.text` back up its main points? |
|
SCOREactionability | After reading `page.text`, how ready is a developer to take a next step with the product? |
|
NOULdiscloses_unofficial | Does `site_footer` state that this guide is unofficial or not affiliated with the vendor? | (criteria なし) |
NOULhas_code_example | Does `page.text` contain program source code or a JSON payload? | (criteria なし) |
NOULhas_performance_numbers | Does `page.text` state performance figures or measured results, such as latency, cost ratios, or accuracy percentages? | (criteria なし) |
NOULattributes_numbers_to_source | If `page.text` states performance figures or measured results, does it attribute them to a source such as official documentation or a cookbook? |
|
NOULwarns_outputs_need_validation | Does `page.text` caution that the model's answers are not guaranteed to be correct, or that the reader should validate on their own data? | (criteria なし) |
NOULmarks_fictional_data | Does `page.text` explicitly label some of its example data or a chart as fictional, made up, or a conceptual illustration rather than a measurement? | (criteria なし) |
NOULexplains_when_not_to_use | Does `page.text` describe a task the product is not meant for, or a case where a different question type or approach should be used instead? | (criteria なし) |
NOULpromotional_hype | Does `page.text` use exaggerated promotional language that goes beyond what it demonstrates? |
|
| ページ | page_role (Choice) | 知識前提 0–3 | 具体性 0–3 | 実行可能性 0–3 | quality (コードで合成) | |
|---|---|---|---|---|---|---|
| 概要 (LP) | landing_overview ✓conf 0.98 · 2位 concept_explainer 0.01 | 1.01 | 2.61 conf 0.61 | 2.86 conf 0.86 | 0.85 | |
| System One | concept_explainer ✓conf 0.99 · 2位 landing_overview 0.01 | 1.02 | 1.04 conf 0.94 | 1.99 conf 0.94 | 0.62 | |
| State | feature_referenceconf 0.43 · 2位 concept_explainer 0.47 | 1.35 | 2.64 conf 0.64 | 2.44 conf 0.53 | 0.81 | 人が確認 |
| Choice | feature_reference ✓conf 1.00 · 2位 concept_explainer 0.00 | 1.26 | 2.95 conf 0.95 | 2.67 conf 0.67 | 0.90 | |
| Score | feature_reference ✓conf 1.00 · 2位 api_reference 0.00 | 1.25 | 2.99 conf 0.99 | 2.59 conf 0.59 | 0.94 | |
| Noul | feature_reference ✓conf 1.00 · 2位 concept_explainer 0.00 | 1.26 | 2.82 conf 0.82 | 2.80 conf 0.80 | 0.90 | |
| Confidence | concept_explainerconf 0.93 · 2位 feature_reference 0.05 | 1.74 | 2.40 conf 0.54 | 2.38 conf 0.60 | 0.84 | |
| 設計パターン | architecture_patterns ✓conf 1.00 · 2位 concept_explainer 0.00 | 1.65 | 2.68 conf 0.68 | 2.19 conf 0.76 | 0.82 | 人が確認 |
| API・SDK | api_reference ✓conf 1.00 · 2位 feature_reference 0.00 | 1.02 | 2.67 conf 0.67 | 2.92 conf 0.92 | 0.89 |
page_role は、作者が事前に想定を決められた 7 ページ中 7 ページで想定と一致(State と Confidence は概念と機能の中間なので想定なし)。「人が確認」は Choice / Score のいずれかの confidence が 0.5 未満だったページで、2 ページ。
| ページ | 非公式と明記 | コード例あり | 性能数値あり | 数値の出典を明示 | 要検証と注意喚起 | 架空データと明記 | 使わない場面を説明 | 誇大な宣伝表現 |
|---|---|---|---|---|---|---|---|---|
| 概要 (LP) | 0.99 | 0.97 | 0.99 | 0.71 | 0.74 | 0.10 | 0.87 | 0.33 |
| System One | 0.99 | 0.11 | 0.32 | 0.50 | 0.98 | 0.97 | 0.96 | 0.23 |
| State | 0.99 | 0.97 | 0.22 | 0.53 | 0.54 | 0.13 | 0.54 | 0.07 |
| Choice | 0.99 | 0.99 | 0.64 | 0.63 | 0.68 | 0.16 | 0.62 | 0.08 |
| Score | 0.99 | 0.99 | 0.45 | 0.91 | 0.98 | 0.12 | 0.81 | 0.05 |
| Noul | 0.99 | 0.99 | 0.45 | 0.64 | 0.79 | 0.14 | 0.77 | 0.15 |
| Confidence | 0.99 | 0.96 | 0.28 | 0.57 | 0.97 | 0.18 | 0.37 | 0.06 |
| 設計パターン | 0.99 | 0.98 | 0.98 | 0.94 | 0.83 | 0.97 | 0.69 | 0.12 |
| API・SDK | 0.99 | 0.99 | 0.96 | 0.81 | 0.64 | 0.09 | 0.12 | 0.06 |
色が濃いほど Yes 寄り。斜線のセルは投機的な質問:has_performance_numbers が 0.5 未満のページでは、コードは attributes_numbers_to_source の答えを読みません。作者の想定では「架空データと明記」が Yes になるのは 設計パターン・System One の2ページです。
quality = (0.35 * concreteness / 3
         + 0.35 * actionability / 3
         + 0.15 * warns_outputs_need_validation.noul
         + 0.15 * (1 - promotional_hype.noul))

needs_human_review = any(a.confidence < 0.5 for a in (page_role, assumed_knowledge, concreteness, actionability))

# 投機的な質問: 数値がないページでは出典の質問を読まない
attribution = attributes_numbers_to_source.noul if has_performance_numbers.noul >= 0.5 else None
ガイドに書いた主張を、公式ドキュメントの逐語抜粋(英語)と一緒に1つの state に入れ、主張ごとに Choice を1問ずつ、計 13 問を1リクエストで聞きました。検出力を確かめるため、わざと誤った主張も混ぜています。
| 型 / 質問 ID | instructions(送ったプロンプト) | criteria |
|---|---|---|
CHOICEc01 〜 c13(全主張で同じ形) | Is the claim in `claims.c01` supported by `sources`? {"focus": "Compare numbers and limits exactly. The claim is written in Japanese; the sources are in English."} |
|
| 主張(日本語のまま state に入れた) | verdict の確率分布 | confidence | 作者の想定との一致 |
|---|---|---|---|
| ガイドの主張 1つの Choice 質問は最大255個の選択肢を受け付ける。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 Score のレベルは最低2つ、最大10まで定義できる。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 Noul の答えには、別建ての confidence は付かない。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 質問 ID はモデルには送られない。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 1リクエストのトークン予算はおよそ 32,000 トークンである。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 多くのクエリは約100ミリ秒で完了する。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 score は、各レベル番号にその確率を掛けて足し合わせた値である。 | 1.00 | ✓ 想定どおり | |
| ガイドの主張 同じリクエスト内の質問は、互いに独立に評価される。 | 0.99 | ✓ 想定どおり | |
| ガイドの主張 13問を1回にまとめると、個別に13回呼ぶより、コストも速度も10倍以上改善する。 | 0.77 | 想定なし | |
| 対照(わざと誤り) Score のレベルは最大20まで定義できる。 | 1.00 | ✓ 想定どおり | |
| 対照(わざと誤り) Noul の 0.5 は「中程度」という意味である。 | 1.00 | ✓ 想定どおり | |
| 対照(わざと誤り) 質問を増やすと、応答時間は質問数に比例して長くなる。 | 0.98 | ✓ 想定どおり | |
| 対照(わざと誤り) Jev は日本語の文章を生成して返すことができる。 | 0.99 | ✓ 想定どおり |
作者が想定を置いた 12 件中 12 件で判定が想定と一致。
ページの役割は想定を置いた7ページすべてで一致。「架空データと明記」は、実際に断り書きのある System One(0.97)と設計パターン(0.97)だけが高く、他の7ページは 0.18 以下。わざと混ぜた誤った主張4件(「Score は最大20レベル」など)も、すべて矛盾・言及なしと正しく判定された。
作者が「概念と機能の中間」として想定を置けなかった State のページは、feature_reference 0.53 対 concept_explainer 0.47 に割れ、confidence は 0.43。しきい値 0.5 を下回って「人が確認」に回った。無理にどちらかを断定せず、不確かさを数値で返している。
「コストも速度も10倍以上改善」という主張に対し、公式の抜粋は「11.5倍安く、9.6倍速い」。速度は10倍に届いていないが、判定は裏付けあり 0.85・矛盾 0.15 だった。ただし confidence は 0.77 で、裏付けありとされた他の8件(0.99 以上)の中で唯一下がっている。しきい値を 0.9 に置けば人のレビューに回せたケース。この結果を受けて、ガイド本文の表現は「10倍前後」に修正した。
「9.6 は 10 以上か」は意味の判断ではなく算術。公式の設計指針どおり、Jev には「主張と出典から数値を選ばせる」までを任せ、比較そのものはコードで行うべきだった。また、1つの主張に「コスト」と「速度」の2つを詰めたのも分解不足で、主張を1事実ずつに分ければ、どちらが外れているかまで分かる。
has_performance_numbers は Score と Noul のページで 0.45。トークン数や確率の数値例を「性能の数値」と見るかが微妙なためで、ゲートを 0.5 に置いた今回は、出典の質問が読まれなかった。Noul の 0.4〜0.6 は Yes とも No とも扱わず、質問の定義を見直すか人に回す帯として設計するのが安全。
入力 3,000〜7,000 トークン・12問のリクエストが、日本からの往復で中央値 482ms。1問あたりに均せば約40ms で、質問を束ねる効果は体感できた。公式の「約100ms」は短い入力を想定した目安で、この条件(長い日本語の state、ネットワーク往復込み)では再現していない。
完全なリクエスト本文とレスポンスは logs/jev-eval/run-20260917T052508Z.jsonl に、質問の一覧は同名の .md に記録しています(API キーは記録していません)。1回の実行結果であり、精度の評価ではありません。
Hands-on · ゲームで実践
「速い・安い・型がある」が本当に効くのか、リアルタイムの 2P 対戦で確かめました。置ける場所の列挙とライン・連鎖の計算はコードが行い、Jev と LLM に同じ候補リストを渡して「どれを選ぶか」だけを競わせています。考えている間もブロックは落ち続けます。
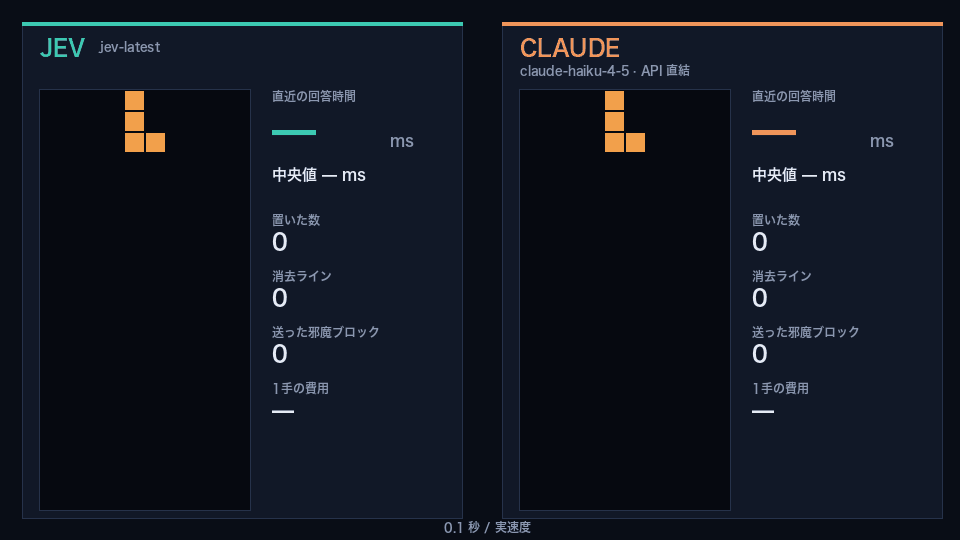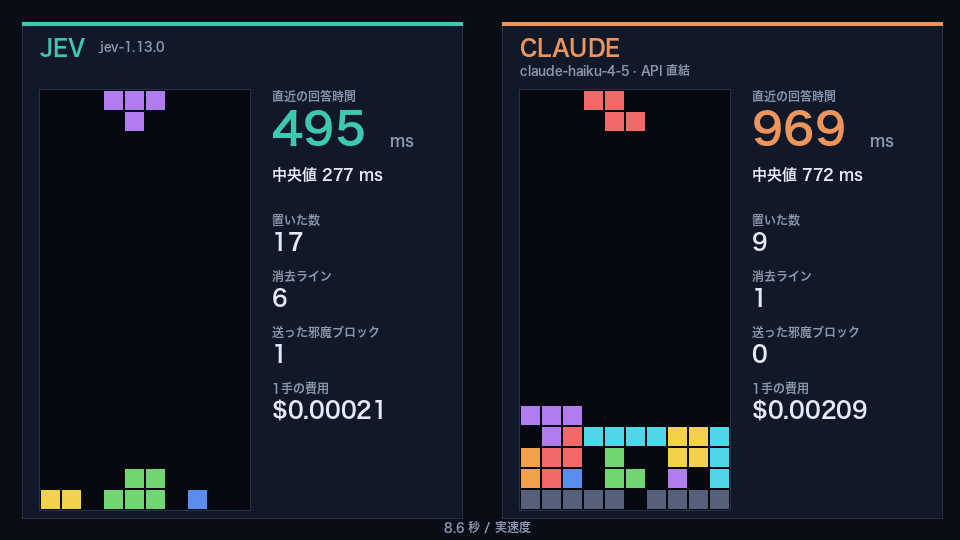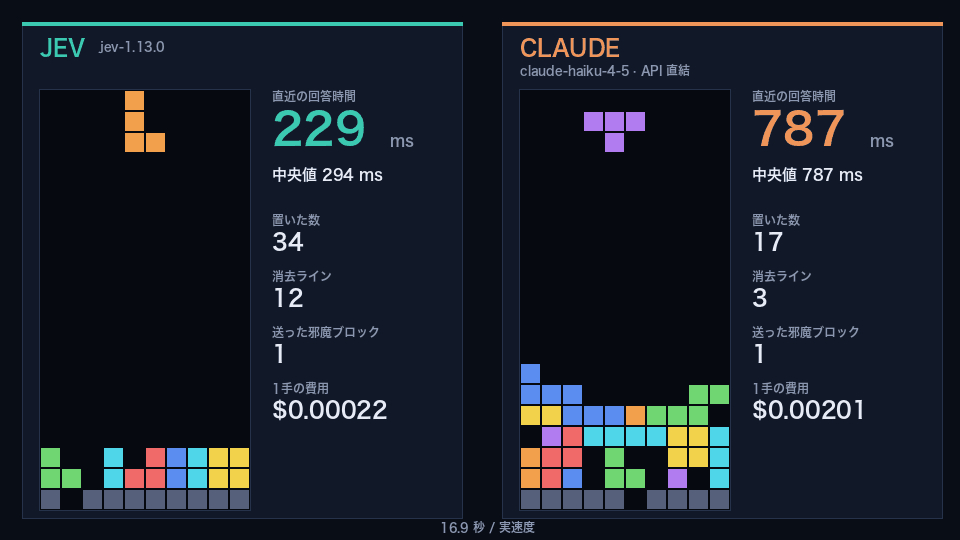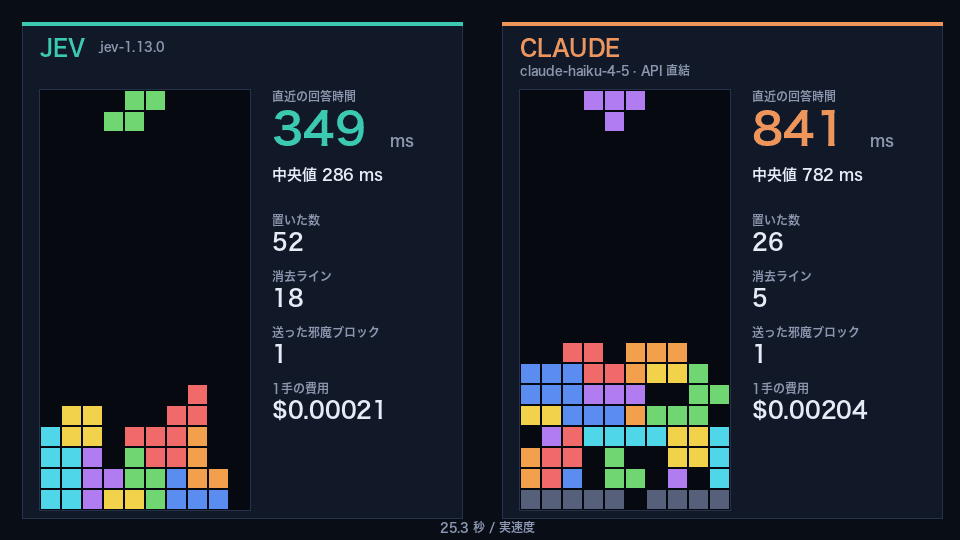
Claude 4 種・GPT-5.6 3 種と各 60 秒 × 2 試合。うち 7 試合は相手が 60 秒もたずに積み上がりました。
最大 34 個の置き方を 1 リクエストで全部採点してこの速さ。最速の LLM(Haiku 4.5)の 2.5 倍、Opus 5 の 9 倍です。
同じくらい丁寧に置ける Opus 5 の 56 分の 1。時間制限なしで置き方の質だけを比べても、最上位 LLM と同水準でした。
評価基準を「穴を作れば 0 点」と書いたら、Jev はそれを忠実に守って、穴のない壁と溝だけの盤面を築いて終了。モデルは同じまま、5 段階の基準・差分をコードで計算・同点はコードが決める、の 3 点に変えると自滅しなくなりました。
「おじゃまを 1 列以上送れる=最上位」と書いたら 2 連鎖を即打ちしました。無駄打ちと早打ちを低い段に明記し、「今が発火どきか」をコードが 1 つの言葉にして渡すと、送ったおじゃまは 4〜7 倍に。
計測は 2026-09-17〜18、日本から。思考 off、API 直結。個人の検証で、TypeSafe・Anthropic・OpenAI とは無関係です。
Deep dives
各機能について、リクエスト/レスポンスの読み方、書き方のコツ、落とし穴を図解で掘り下げています。
LLM と何が違うのか。3つのアーキテクチャ、学習方法 RLCD、較正とは何か。
INPUT何をどう渡すか。JSON 構造、バッククォートのパス参照、質問の分解。
PRIMITIVE選択肢の書き方、確率分布の読み方、紛らわしい選択肢の切り分け。
PRIMITIVEレベルの定義、スコアの計算式、よいレベル記述と悪いレベル記述。
PRIMITIVEYes の確率の読み方。「0.5 は中程度ではない」という落とし穴。
SIGNAL確率と確信度の違い、3段階の行動設計、リスクに応じた閾値。
ARCHITECTUREファンアウト、確信度ゲート、合成スコア、インテントルーティングを図とコードで。
REFERENCEエンドポイント、リクエスト/レスポンスの構造、制限値、エラー、始め方。
Get started
POST https://api.typesafe.ai/v1/systemone に Bearer トークン付きで JSON を送る。
pip install typesafe-sdk。環境変数 TYPESAFE_API_KEY を読み、既定で jev-latest を呼ぶ。
Claude Code などのコーディングエージェントに TypeSafe の設計作法を教えるスキルが公開されている。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()  # TYPESAFE_API_KEY を環境変数から読む

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.035
print(response.answers["is_urgent"].noul)     # 0.999